ДЗ2: EDA — ДТП во Владимирской области
Домашка про исследовательский анализ данных: взял реальную выгрузку ДТП по Владимирской области с dtp-stat.ru, почистил, построил дашборд на Streamlit, проверил три статистические гипотезы и сделал пространственный анализ через PCA/t-SNE и карту.
Страница построена так: сначала вся теория с нуля (если не знаешь, что такое p-value или PCA — начни отсюда), потом коротко что требовало задание, потом — какие решения мы приняли и почему, и в конце — как всё это работает вместе, без единой строчки кода.
Часть 1. Теория с нуля
Что вообще такое EDA
Есть большая таблица: 23 485 строк, каждая строка — одно ДТП. У каждой строки есть колонки: когда произошло, где, какой тип аварии, сколько людей пострадало, было ли темно и так далее. EDA (Exploratory Data Analysis) — это просто «разведка» этой таблицы: посмотреть на неё глазами через графики, найти что-то любопытное, проверить первые догадки статистикой. Не доказательство теоремы, а первый структурированный взгляд.
Гипотеза, H0 и H1 — презумпция невиновности для данных
Допустим, кажется, что «в темноте без освещения ДТП тяжелее». Это догадка. Но глаз может обманывать — вдруг это просто случайность на конкретных данных? Чтобы проверить догадку по-настоящему, формулируют две гипотезы:
- H0 (нулевая гипотеза) — скучное предположение: «на самом деле никакой разницы нет, то, что видно на графике — просто шум». Это как презумпция невиновности: пока не доказано обратное, считаем, что эффекта нет.
- H1 (альтернативная) — то, что реально подозреваем: разница есть.
Тест никогда не «доказывает» H1. Он либо даёт достаточно веских оснований отвергнуть H0 (тогда данные говорят в пользу H1), либо не даёт — и тогда просто не получилось отличить эффект от случайности на этих данных, что не то же самое, что «эффекта нет».
p-value — самое неправильно понимаемое число в статистике
p-value отвечает не на вопрос «какова вероятность, что H0 верна», а на другой: если бы H0 была верна (разницы правда нет) — насколько странным был бы результат, который мы реально получили?
Маленькое p-value (например, 0.0001) значит: «если бы разницы правда не было, увидеть такой результат было бы почти невозможно». Значит, разница, скорее всего, настоящая. Это и есть самая частая ошибка новичков — путать «маленькая вероятность странного результата при H0» с «маленькая вероятность того, что H0 верна». Это разные вещи.
Уровень значимости — порог, который выбирают заранее (обычно 0.05 = 5%). Если p-value меньше этого порога — разницу считают настоящей, H0 отвергают.
Доверительный интервал — не то, что кажется на первый взгляд
95% доверительный интервал — частая ошибка думать, что это «диапазон, где лежат 95% данных». На самом деле: если бы можно было повторить весь сбор данных много раз и каждый раз строить такой интервал заново, примерно 95% из построенных интервалов накрыли бы истинное (неизвестное) значение эффекта.
Практический смысл проще: интервал показывает не только «есть разница или нет», но и насколько она большая, с поправкой на то, что выборка не бесконечна. Если интервал не захватывает ноль — разница, скорее всего, не случайна.
Bootstrap — как получить доверительный интервал без формул
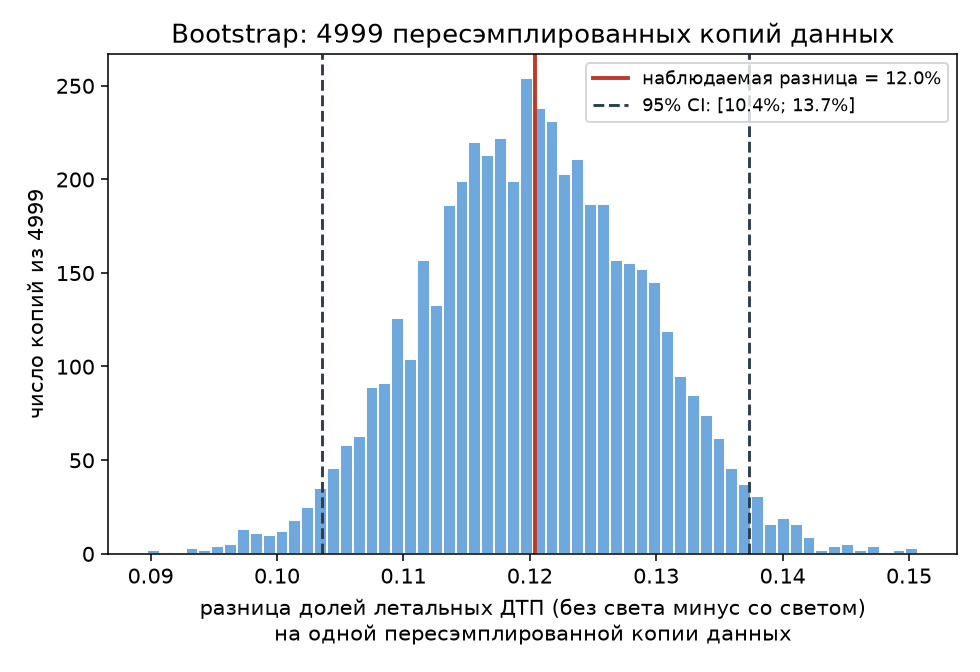
Bootstrap звучит сложно, а устроен просто. Есть, например, две группы ДТП: «темно без света» и «темно со светом». Есть настоящая разница долей летальных ДТП между ними — допустим, 12%.
Дальше компьютер тысячи раз подряд делает так: берёт исходные данные и случайно вытаскивает из них строки с возвращением (то есть одна и та же строка может попасться повторно, а какая-то — не попасться вообще), столько же строк, сколько было изначально. На этой «перемешанной копии» снова считается разница долей. Повторили 4999 раз — получили 4999 немного разных значений разницы. Разброс этих 4999 значений и есть доверительный интервал.
На картинке ниже — реальный результат: 4999 гистограмм-«копий» легли колоколом вокруг настоящей разницы 12.0%, а 95% этого колокола (между пунктирными линиями) — и есть доверительный интервал [10.4%; 13.7%].
Перестановочный тест — как получить p-value без формул
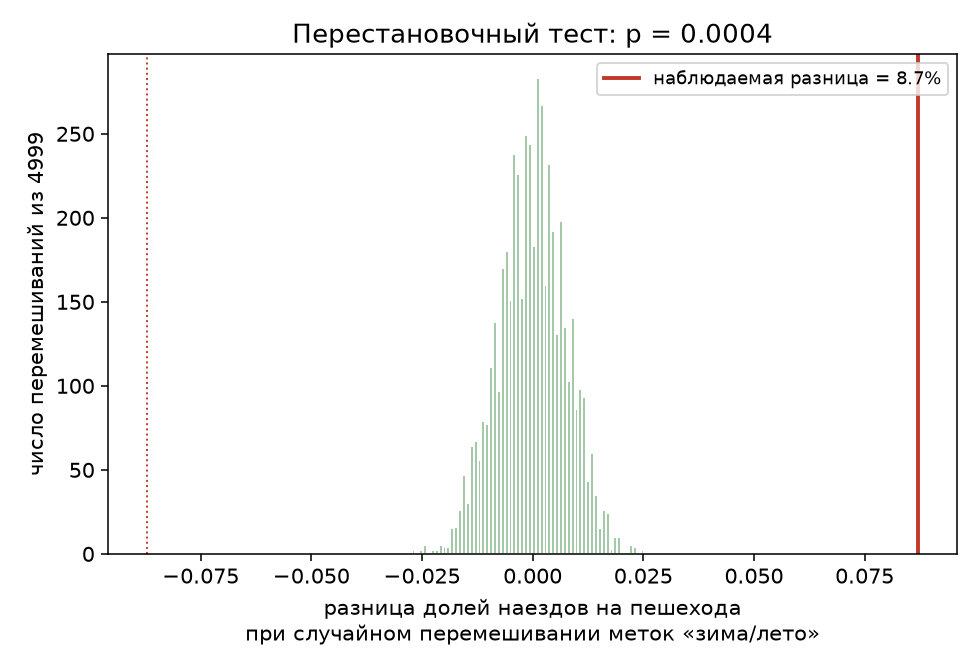
Перестановочный тест — похожая идея, но для p-value. Логика: если бы метка группы (например, «зима» или «лето») на самом деле ничего не значила, её можно было бы случайно перемешать между теми же самыми ДТП — и разница между группами должна была бы получаться примерно такой же, как настоящая.
Компьютер тысячи раз случайно перемешивает метки «зима/лето» между теми же наблюдениями и каждый раз пересчитывает разницу. p-value — это доля перемешиваний, давших разницу не меньше настоящей. На графике ниже зелёным — 4999 таких случайных разниц; они толпятся вокруг нуля (при случайной метке разницы в среднем быть не должно). Красная линия — настоящая, реальная разница (8.7%) — стоит настолько далеко за пределами этого облака, что ни одно из 4999 случайных перемешиваний до неё даже не дотянулось.
Хи-квадрат и Mann-Whitney — готовые формулы вместо тысяч повторов
Хи-квадрат — это готовая формула (не нужно ничего пересэмплировать), которая сравнивает таблицу «сколько ДТП в каждой группе с каждым исходом» с тем, какой была бы эта таблица, если бы группа и исход были вообще никак не связаны. Работает нормально, только если в каждой ячейке таблицы ожидается не меньше 5 наблюдений — на наших тысячах записей это всегда с запасом.
Mann-Whitney — ещё одна готовая формула, но не для долей, а для порядка. Все значения переводятся в ранги (кто меньше, кто больше) и проверяется, не сдвинуты ли ранги одной группы систематически относительно другой. Полезен, когда сравнивается не бинарный исход (да/нет), а целая шкала (лёгкий/тяжёлый/с погибшими).
Effect size — самое важное число, которое часто забывают
Мало сказать «p < 0.05, значит есть эффект». Величина эффекта — то, что реально отвечает на вопрос «а насколько это важно на практике»: разница в 12 процентных пунктов — это большой, практически значимый эффект, а не просто «математически отличается от нуля». p-value говорит «есть ли эффект вообще», effect size говорит «насколько он большой».
Связь — это не причина
Отдельно стоит держать в голове: если два явления связаны (например, «в темноте без света ДТП тяжелее»), это ещё не значит, что одно является причиной другого напрямую. За связью может стоять что-то третье. Отделять наблюдаемую связь от предположения о её причине — важная часть любого честного анализа данных.
PCA — сжимаем десятки признаков в картинку
Вот тут — самое важное для тех, кто вообще не знает, что это такое.
У каждого ДТП — куча признаков: тип аварии, освещение, сезон, территория, погода, число участников и так далее. После того как всё это закодировано в числа, получается около тридцати столбцов на одну запись. Тридцать чисел нельзя нарисовать на графике — глаз видит максимум 2-3 оси одновременно.
PCA (Principal Component Analysis) решает эту проблему: он находит новую систему координат (две «оси»), составленную из смеси всех исходных тридцати признаков, так, чтобы вдоль этих двух новых осей данные были разбросаны максимально широко — то есть чтобы на плоской картинке сохранилось как можно больше «интересного» из исходных тридцати измерений.
Представь фотографа, который снимает сложную скульптуру с одного случайного угла — фото может быть плоским и неинформативным. PCA — это как найти тот единственный угол съёмки, с которого на плоской фотографии видно максимум формы скульптуры. Дальше можно сказать, сколько процентов «формы» вообще осталось видно на этом фото (это называется объяснённая дисперсия) — и объяснить, что примерно означает каждая из двух осей на фотографии, посмотрев, какие из исходных признаков сильнее всего на неё влияют.
t-SNE — другой способ сжатия, ищет «своих соседей»
t-SNE решает похожую задачу — сжать много признаков в 2D-картинку — но по-другому. PCA старается сохранить общее «направление разброса» всех данных сразу. t-SNE, наоборот, для каждой точки смотрит, кто был её ближайшими соседями в исходном многомерном пространстве, и старается на плоской картинке рассадить точки так, чтобы бывшие соседи остались рядом друг с другом. Из-за этого t-SNE лучше находит компактные группы (кластеры) похожих объектов, но хуже показывает общую «форму» всех данных сразу.
У t-SNE есть параметр perplexity — грубо говоря, «сколько соседей учитывать» для каждой точки. Маленькое значение — получаются мелкие, дробные группки, большое — более крупные и стабильные скопления.
Важная ловушка, в которую попадают почти все новички: на t-SNE-картинке нельзя сравнивать размер пятен между собой и расстояния между разными пятнами — они ничего не значат. Важен только состав: кто оказался соседом с кем.
Карта: точки и сетка
Точками на карте можно показать каждое ДТП отдельно. Но если точек тысячи, они сливаются в кашу — тогда территорию режут на равные квадраты (сетку) и красят каждый квадрат по числу ДТП внутри него или по доле каких-то исходов. Для ровной нарезки на квадраты в километрах нужна карта в метрической проекции — обычные широта/долгота устроены так, что «квадрат» в градусах на самом деле не квадрат на реальной земле, особенно чем дальше от экватора.
Часть 2. Что требовалось по заданию (коротко)
Задание — исследовать данные о ДТП в своём регионе (регион назначается автоматически по GitHub-логину) и оформить результат в виде дашборда и короткого отчёта. Пять частей:
- Данные и визуальное исследование. Описать источник и период, определить единицу анализа, проверить данные на пропуски/дубликаты/аномалии и явно написать, что с ними сделали. Сделать 10-12 визуализаций строго определённых обязательных типов (временной ряд, категориальный, распределение, сравнение групп с интервалом, heatmap/scatter, карта, PCA/t-SNE) плюс 2-3 своих вопроса, один из которых должен родиться из наблюдения на другом графике. Один график улучшить и приложить «до/после».
- Три статистические гипотезы, у каждой — минимум два разных теста, эффект в понятных единицах, доверительный интервал, p-value, вывод. Хотя бы раз использовать bootstrap или перестановочный тест. В отчёт идут все три результата, даже незначимые.
- Карта: точки и агрегация вместе, проверка координат, сколько записей не отобразилось, легенда, источник подложки, объяснение одной пространственной закономерности.
- PCA и t-SNE: самому выбрать объект и признаки, объяснить выбор. Для PCA — доля дисперсии и смысл хотя бы одной компоненты. Для t-SNE — два запуска с разными параметрами на тех же объектах, сравнение.
- Дашборд: фильтр периода + хотя бы один категориальный, три главных вывода, предложение для дальнейшего исследования.
Сдаётся app.py (дашборд), analysis.md (отчёт), requirements.txt. Данные в репозиторий не загружаются. На защите — показать дашборд, провести один вывод от сырых данных до интерпретации, объяснить поведение фильтров.
Часть 3. Что мы сделали и какие решения приняли
Здесь — каждое решение, которое пришлось принять самим (там, где задание оставляло выбор), с объяснением почему именно так.
Регион — выбора не было, это автоматика
Задание не давало выбирать регион: он вычисляется автоматически из GitHub-логина, чтобы у всех студентов были разные данные и работы не совпадали. Выпал — Владимирская область.
Единица анализа — задание требовало определить её самому
Задание прямо требует: «определите единицу анализа». Мы выбрали одно ДТП (одна запись в выгрузке) в качестве единицы, а не, например, «один участник» или «одна территория за месяц». Это самый естественный вариант для этой выгрузки: у каждой записи и так есть все нужные свойства (время, место, тяжесть), а участники и транспорт остаются вложенным списком внутри записи, не размножая строки.
Проблемы в данных — задание требовало их найти и объяснить, что сделали. Вот что мы нашли
Битые координаты. У 58 записей из 23 485 координаты либо отсутствуют, либо явно за пределами области — некоторые вообще стоят ровно на одной и той же паре чисел, что похоже на техническую заглушку, а не на реальное место. Решение: эти записи просто не участвуют в карте, но остаются во всех остальных расчётах — там, где координата не нужна, выбрасывать запись целиком не за что.
Поле "район" врёт для трети записей — вот тут подробно, на конкретном примере. Каждая запись о ДТП должна быть привязана к конкретному району области (например, «Александровский район»). Но у 8 339 записей из 23 485 (это треть всех данных!) в этом поле стоит не название района, а просто «Владимирская область» — то есть название всей области целиком, слишком общее и бесполезное значение.
Разбираемся, откуда это взялось: смотрим на адрес этих же записей и видим, что почти все они произошли в главном городе какого-то района — например, адрес «г Александров, ул. Мира» (а город Александров — это административный центр Александровского района). Похоже, источник данных просто не доразметил район для аварий, произошедших именно в райцентре, и вместо конкретного района написал название всей области.
Почему это вообще проблема, а не мелочь. Одна из наших гипотез — сравнить, отличаются ли ДТП в городах от ДТП в районах. Если оставить данные как есть, получится, что «Владимирская область» — это как будто отдельный псевдорайон с 8 339 записями, больше, чем в любом настоящем районе. Сравнение «город против района» стало бы нечестным: треть всех данных болталась бы в мусорной категории, которая на самом деле не является ни городом, ни районом, а просто плохо размеченными записями из десятков разных мест.
Как починили. Взяли адрес каждой такой записи и посмотрели, с чего он начинается: - если адрес начинается с «г Владимир» — значит, это городской округ Владимир (областной центр, у него нет своего района, он сам по себе городской округ); - если адрес начинается с названия какого-то другого города, который является центром района (например, «г Александров», «г Судогда», «г Петушки» и так далее) — запись возвращается в свой настоящий район по заранее составленному списку соответствий «город → его район».
Пример «было → стало» на одной записи: запись про ДТП по адресу «г Александров, ул. Мира, 5» изначально имела поле район = «Владимирская область». После починки поле район у этой же записи стало = «Александровский район», потому что город Александров — это центр Александровского района.
После этой починки получилось честное деление на три группы: городской округ (Владимир и ещё несколько крупных городов области — 9 335 записей), район (19 обычных районов — 13 784 записи) и прочее — то, что так и не удалось привязать к конкретному месту (в основном ДТП на трассах без привязки к населённому пункту, 366 записей, 1.6% от всех данных) — эта маленькая остаточная группа в сравнение «город/район» не включается, потому что непонятно, куда её отнести.
Поле "число участников" не всегда совпадает с реальностью. У 6.5% записей число участников, указанное в отдельном поле, расходится с тем, что реально перечислено в списках участников этой же записи. Значит, этому числу нельзя доверять буквально там, где важна точность — там, где счёт участников критичен, лучше считать их напрямую по спискам, а не по этому полю.
Какие три гипотезы выбрали и почему именно эти
Задание требовало три гипотезы по теме своего исследования — темы не заданы жёстко, выбор наш. Выбрали:
- Освещение и тяжесть ДТП (темно без света vs темно со светом) — потому что на первом же взгляде на данные бросилось в глаза, что доля тяжёлых ДТП в темноте заметно выше.
- Сезон и тип ДТП (доля наездов на пешехода зимой vs летом) — эта идея прямо подсказана условием задания, которое само спрашивает «как меняется картина зимой».
- Город против района и тяжесть ДТП — тоже прямая подсказка из условия задания («почему в одних районах больше происшествий, а в других тяжелее последствия»), и она стала возможна только благодаря починке поля «район», описанной выше.
Какие тесты выбрали для каждой гипотезы и почему именно эти
Задание требовало минимум два разных теста на гипотезу и хотя бы один раз за всю работу — bootstrap или перестановочный тест. Мы распределили так:
- Освещение: хи-квадрат (быстрая проверка самой связи) + bootstrap (даёт доверительный интервал для разницы в процентах).
- Сезон: хи-квадрат + перестановочный тест (выполняет обязательное требование задания про перестановочный тест/bootstrap явным образом).
- Город/район: хи-квадрат + Mann-Whitney (Mann-Whitney тут выбран специально, чтобы проверить не только бинарный исход «погиб кто-то или нет», а сразу всю шкалу тяжести — лёгкий/тяжёлый/с погибшими, — это независимая проверка тем же направлением, но другим способом счёта).
Какие признаки выбрали для PCA/t-SNE и почему тяжесть туда не пошла
Задание требовало самим выбрать объект и признаки и объяснить выбор. Объектом выбрали отдельное ДТП (не территорию), а признаками — только обстоятельства: тип аварии, освещение, территория, сезон, будни/выходной, погода, дефекты дороги, число участников.
Сознательно не включили тяжесть аварии (сколько погибло/пострадало) в признаки. Если бы включили — PCA почти тривиально построил бы оси вокруг самой тяжести, и результат был бы неинтересным («тяжёлые ДТП отличаются от нетяжёлых, потому что у них другая тяжесть» — бессмысленный вывод). Вместо этого интереснее было проверить: а можно ли вообще отличить тяжёлые ДТП от нетяжёлых, зная только обстоятельства, без прямой подсказки?
Оказалось — почти нет: освещение и территория группируются на картинке куда чётче, чем тяжесть, значит, тяжесть определяется чем-то ещё, чего в этих признаках просто нет (скорее всего — конкретной скоростью в момент ДТП, которой в данных нет вообще).
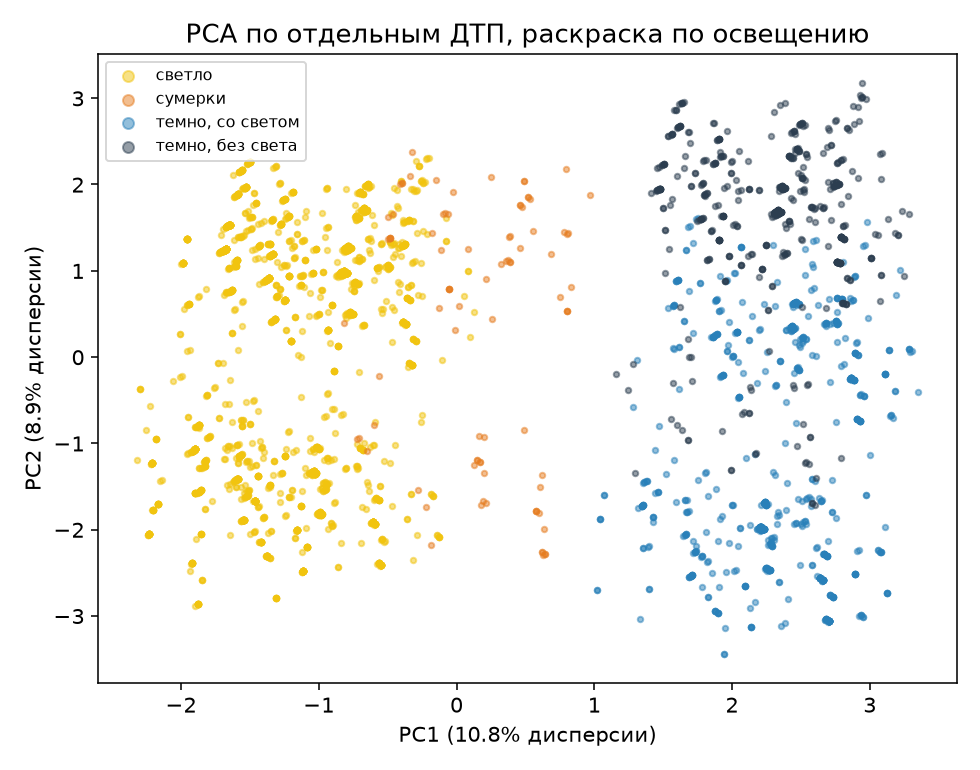
Ниже — реальная картинка PCA, раскрашенная по освещению: по горизонтальной оси (PC1) две чёткие тучи точек — слева жёлто-оранжевая (светлое время/сумерки), справа сине-серая (темнота) — обстоятельства ДТП сами по себе разделились ровно так, как и предсказывает интерпретация оси.
Для t-SNE — тот же самый набор объектов и признаков, но два запуска с разным perplexity (30 и 5), чтобы выполнить требование задания «сравните картинки при разных параметрах».
Карта: размер сетки, проекция, доверительный интервал
Задание требовало разумный масштаб агрегации — выбрали квадраты 4×4 километра: достаточно мелко, чтобы видеть форму дорог и городов, и достаточно крупно, чтобы в большинстве ячеек хватало ДТП для честной статистики. Для доли летальных ДТП внутри ячейки поставили условие «минимум 5 ДТП в ячейке», иначе единственная авария в пустой ячейке давала бы 100% — искажённая и нечестная цифра.
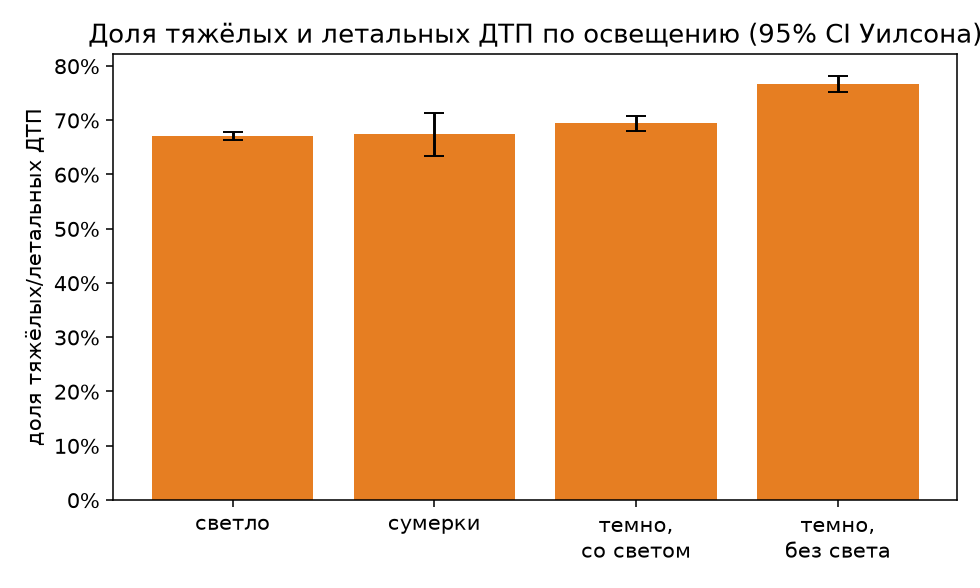
Для интервалов вокруг долей (например, «доля тяжёлых ДТП по освещению») выбрали интервал Уилсона вместо обычной школьной формулы — обычная формула на малых выборках или долях, близких к 0%/100%, может выдать абсурдный интервал, выходящий за пределы [0%; 100%]. Уилсон этой проблемы не имеет.
Дашборд: что фильтруется, а что нет — и почему
Задание требовало фильтр периода и хотя бы один категориальный. Добавили оба — период и тип территории/тип ДТП.
Но гипотезы и PCA/t-SNE сознательно не пересчитываются при смене фильтра — это разрешено самим заданием («статистику и проекции можно посчитать заранее, но подпишите, на какой выборке»). Если бы гипотеза пересчитывалась при каждом движении ползунка периода, её результат плясал бы вместе с фильтром, и сравнивать числа между собой стало бы бессмысленно — поэтому они посчитаны один раз по всей очищенной выгрузке, а на экране это прямо подписано.
Часть 4. Итог: как всё это соединилось
Скачали реальную выгрузку ДТП по своему региону, проверили и почистили данные (три проблемы и решения — в части 3 выше), и дальше выстроили всю работу поверх этой очищенной таблицы: графики, три гипотезы, карту, PCA/t-SNE — и собрали всё в один интерактивный дашборд.
Три гипотезы дали устойчивый результат: все три оказались значимыми, с большой величиной эффекта, и каждая подтверждена двумя независимыми тестами (освещение +12 п.п., сезон +8.7 п.п., город/район +9 п.п. — методика для каждой описана в части 3).
Карта показала пространственную закономерность: самая плотная зона ДТП — центр Владимира, а повышенная доля летальных исходов ложится не по всей площади районов, а узкими полосами вдоль трасс — это напрямую перекликается с гипотезой про город/район.
PCA и t-SNE показали, что обстоятельства ДТП (освещение, территория) группируются в данных чётко и осмысленно, а вот тяжесть последствий одними обстоятельствами почти не объясняется — значит, зависит от чего-то, чего в выгрузке просто нет (скорее всего, скорости в момент ДТП).
Три главных вывода, к которым пришли в итоге: освещение — самый сильный из найденных факторов тяжести ДТП; город чаще генерирует ДТП, но район — тяжелее по последствиям; зима меняет не только количество ДТП, но и их состав (больше наездов на пешехода). Каждый вывод сопровождается честной оговоркой: это наблюдаемая связь в данных, а не доказанная причина — данных о скорости, трафике и типе дороги в выгрузке нет, чтобы разделить эти причины напрямую.
Всё это собрано в единый интерактивный дашборд с фильтром периода и категорий, где фильтр реально меняет отображаемые графики и метрики, а тяжёлые в вычислении блоки (гипотезы, PCA/t-SNE) посчитаны один раз и явно подписаны, на какой выборке.
Дашборд и analysis.md — это не два разных набора выводов, а один и тот же результат в двух формах. Дашборд (поднимается командой make run, открывается в браузере) — живая, интерактивная версия: по ней и идёт показ на защите, экран за экраном. analysis.md — тот же самый анализ текстом, требуется заданием как отдельный файл, читается на GitHub без запуска чего-либо. Три главных вывода на вкладке «Выводы» в приложении и в разделе «Итог» файла analysis.md — буквально одинаковые.
Часть 5. Все визуализации по одной — что говорить у каждой
Именно это, скорее всего, придётся объяснять вживую на защите, экран за экраном. На каждый график — что это, зачем он вообще тут и что по нему видно. Всего 11 плюс один бонусный.
1. Временной ряд ДТП по месяцам
Вкладка «Динамика». Обычная линия: по горизонтали — месяцы с начала 2015 по январь 2026, по вертикали — сколько ДТП произошло в этом месяце. Закрывает обязательный пункт ТЗ «временной ряд» — без него нельзя вообще понять, растёт число аварий, падает или колеблется по сезонам.
Что видно: последний месяц выгрузки (январь 2026) обрывается вниз — это не реальный провал, а просто конец периода данных, дальше января выгрузки не существует. Сравнивать этот месяц с полными годами нельзя, это прямо подписано под графиком.
2. Тепловая карта «час дня × день недели»
Вкладка «Динамика». Сетка: по одной оси — час суток (0-23), по другой — день недели, а число ДТП в каждой клетке закодировано цветом (чем темнее/ярче — тем больше аварий). Закрывает пункт ТЗ про heatmap для изучения связи двух категориальных величин.
Что видно: заметные вечерние пики именно в будние дни — час пик после работы даёт больше аварий, чем то же время в выходной.
3. [Свой вопрос] Доля тяжёлых/летальных ДТП по часам суток
Вкладка «Динамика». Два линейных ряда по 24 точкам (по одной на час): доля ДТП категории «тяжёлый + с погибшими» и отдельно доля «только с погибшими». Это не обязательный тип из ТЗ, а собственный вопрос — родился прямо из наблюдения на гипотезе про освещение: увидев, что в темноте без света ДТП тяжелее, захотелось посмотреть на всю картину по всем 24 часам, а не только в грубом сравнении «темно/светло».
Что видно: доля тяжёлых ДТП растёт плавно к ночи, а не скачком — то есть дело не в одном конкретном «переключателе темно/светло», а в постепенном ухудшении условий с наступлением вечера.
4. Типы ДТП, «до» и «после»
Вкладка «Категории и распределения». Столбчатая диаграмма — по каждой категории ДТП (столкновение, наезд на пешехода и т.д.) высота столбца равна числу таких аварий. Показана в двух версиях оформления. Закрывает сразу два пункта ТЗ: «столбчатая диаграмма для категорий» и отдельное обязательное требование сделать и показать пример «до/после» с объяснением, что улучшили.
Что видно: «до» — столбцы в произвольном порядке, подписи вертикальные, число аварий приходится прикидывать по сетке на глаз. «После» — отсортировано по убыванию, горизонтально, число подписано прямо у столбца. Сразу видно, что столкновения (10 312) и наезды на пешехода (5 346) на порядок обгоняют остальные категории — на «до» эту разницу приходилось высчитывать самому.
5. ECDF числа участников в ДТП
Вкладка «Категории и распределения». ECDF — это график, где по горизонтали отложено значение признака (тут — число участников одного ДТП), а по вертикали — какая доля всех ДТП имеет ЭТО значение или меньше. Закрывает пункт ТЗ «распределение числового признака».
Что видно: кривая почти сразу взлетает и выполаживается — то есть подавляющее большинство ДТП укладывается в 2-3 участника, а дальше идёт длинный тонкий хвост редких аварий с большим числом участников.
6. Доля тяжёлых/летальных ДТП по освещению с доверительным интервалом Уилсона
Вкладка «Категории и распределения». Столбцы с «усами» (вертикальными чёрточками сверху) — по каждой из четырёх категорий освещения (светло, сумерки, темно+свет, темно без света) столбец показывает долю тяжёлых/летальных ДТП, а ус — доверительный интервал этой доли. Закрывает пункт ТЗ «сравнение показателей нескольких групп с доверительным интервалом» — это ровно тот график, который навёл на первую гипотезу.
Что видно: у категории «темно без света» столбец заметно выше остальных, и её ус не пересекается с остальными — уже на глаз понятно, что разница не случайна, дальше это подтверждается тестами в гипотезе №1.
7. [Свой вопрос] Нарушения участников в ДТП с погибшими
Вкладка «Категории и распределения». Горизонтальные столбцы: топ-12 формулировок нарушений (выезд на встречную полосу, превышение скорости и т.д.), длина столбца — сколько раз это нарушение встретилось у участников именно летальных ДТП. Свой вопрос, не из обязательного списка — идея взята прямо из условия задания.
Что видно: список ожидаемый (скорость, встречка, переход в неположенном месте), но интересно увидеть его именно в цифрах своей выгрузки, а не абстрактно.
8. Точечная карта
Вкладка «Карта». Каждое ДТП — отдельная точка на карте области, цвет точки — тяжесть аварии. Закрывает пункт ТЗ «точечная карта».
Что видно: где физически гуще всего происходят аварии — видно скопление вокруг крупных городов и вдоль основных дорог. При большом числе точек показывается случайная подвыборка 5 000 штук — иначе карта тормозит и превращается в кашу, но это только для отрисовки, остальные цифры дашборда считаются по всем записям.
9. Агрегированная карта — сетка 4×4 км
Вкладка «Карта». Территория порезана на одинаковые квадраты 4×4 км, каждый квадрат закрашен по числу ДТП внутри него или (переключателем) по доле летальных исходов. Закрывает пункт ТЗ «агрегированная карта».
Что видно: самая частая ячейка — в центре Владимира (724 ДТП за весь период). А вот повышенная доля летальных исходов ложится не равномерно по площади районов, а узкими вытянутыми полосами вдоль трасс — это прямая иллюстрация к гипотезе №3 про город и район.
10. PCA-проекция
Вкладка «PCA и t-SNE». Двумерный scatter-плот: каждая точка — одно ДТП (из подвыборки 4 000), координаты по двум осям PC1/PC2 получены сжатием примерно 30 признаков в 2 числа (как это работает — см. часть 1 выше). Закрывает пункт ТЗ «проекция PCA».
Что видно: по горизонтальной оси (PC1) — два чётких облака точек, слева светлое/сумеречное время, справа тёмное — обстоятельства ДТП сами разделились ровно так, как и предсказывает интерпретация оси. Сохранено 19.7% исходной изменчивости данных — немного, но ожидаемо для набора почти целиком из категориальных признаков.
11. t-SNE, два запуска (perplexity 30 и 5)
Вкладка «PCA и t-SNE». Две похожие проекции рядом, те же самые объекты и признаки, что и в PCA, но сжатые другим методом и с разным значением parameter perplexity. Закрывает пункт ТЗ «проекция t-SNE со сравнением параметров» — по правилам задания оба запуска вместе считаются ОДНИМ пунктом, не двумя.
Что видно: при perplexity=5 картинка дробится на много мелких пятен, при perplexity=30 пятна крупнее и стабильнее — ожидаемый эффект параметра. Раскраска по освещению и территории даёт куда более чёткие скопления, чем раскраска по тяжести — то есть обстоятельства группируются хорошо, а вот саму тяжесть по одним обстоятельствам не разглядеть.
Бонус (не считается в 10-12)
На вкладке «Обзор» есть ещё один вспомогательный график — столбцы «число ДТП по годам». Он не входит в обязательный список из 10-12: это просто иллюстрация к тому, что последний год в выгрузке неполный, часть проверки данных, а не отдельная исследовательская визуализация.
Итого: 11 визуализаций, из них 9 закрывают все обязательные типы из ТЗ, 2 — собственные вопросы (задание просит 2-3, минимум выполнен).
Вопросы, которые могут задать на защите
«Почему в PCA всего ~20% дисперсии — это же мало?» Потому что почти все признаки категориальные, а не числовые с естественной шкалой — у таких наборов дисперсия почти никогда не концентрируется в двух компонентах, это ожидаемо. Важнее, что компоненты интерпретируются осмысленно, а не сама цифра процента.
«Почему для города/района дополнительно Mann-Whitney, а не просто второй хи-квадрат?» Задание требует именно разных тестов, а не повторения одного и того же метода — Mann-Whitney смотрит на другую версию вопроса (вся шкала тяжести целиком, а не бинарный «летальный/нет»), это независимая проверка того же направления эффекта.
«Как понять, что вывод про район/город не просто совпадение с тем, что районы больше по площади?» Честный ответ — до конца не понять именно из этой выгрузки: в ней нет данных о трафике или длине дорог, поэтому «доля летальных ДТП выше в районе» — это наблюдаемая связь, а причину (скорость, освещённость, тип дороги) выгрузка напрямую разделить не позволяет.
«А что если бы p-value оказался больше 0.05 — вы бы выкинули гипотезу из отчёта?» Нет, задание прямо требует включить результаты всех трёх проверок независимо от значимости — незначимый результат тоже результат, он говорит «на этих данных эффект отличить от случайности не получилось», а не «эффекта точно нет».